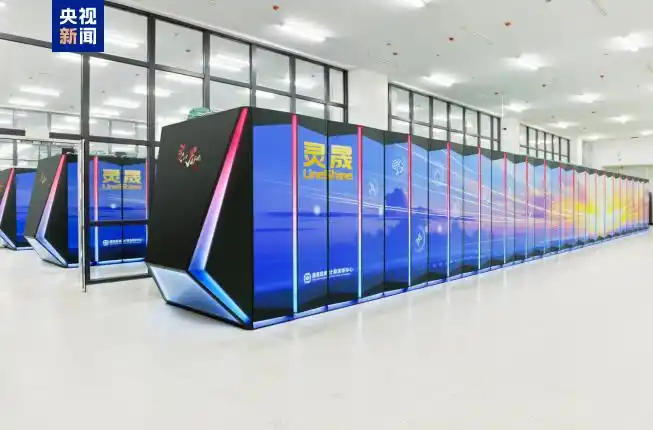
当地时间2026年11月17日,在美国芝加哥举行的SC26国际超级计算大会上,新一期全球超算TOP500榜单正式揭晓。部署于国家超级计算深圳中心的“灵晟”E级超算,以 2.198 EFlops(每秒219.8亿亿次)的Linpack双精度实测性能蝉联世界第一,并同时保持HPCG榜单榜首,实现“双榜卫冕”。这是继2026年6月ISC2026大会首次登顶后,“灵晟”连续第二期稳居全球超算之巅。
📊 榜单表现:领先幅度与“双榜”含金量
“灵晟”对第二名美国“El Capitan”(1.809 EFlops)的领先幅度约为21%,优势明显。本期榜单仅有五台E级超算上榜,第三至第五名依次为美国“Frontier”(1.353 EFlops)、“Aurora”(1.012 EFlops)和德国“JUPITER Booster”(1.000 EFlops)。
更具指标意义的是HPCG(高性能共轭梯度)榜单。“灵晟”以22 PFlops同样位列世界第一,领先第二名约26%。HPCG侧重衡量系统在真实应用中的访存与互联通信效率,而非单纯的峰值浮点性能,这一结果说明“灵晟”的领先并非靠某一项指标的“偏科”,而是在实际计算负载下的均衡优势。
🔬 技术路线的关键突破:纯CPU打赢GPU霸权
“灵晟”最受国际超算界关注的特点,在于它走了一条与榜单上多数美国E级系统截然不同的技术路线:纯CPU架构。
当前主流E级超算普遍依赖GPU加速卡堆叠算力,而“灵晟”完全依靠CPU实现E级性能。其核心是自研的LX2处理器(ARMv9架构,单颗304核,1.55GHz),全系统集成约1378万个CPU核心,整机功耗控制在42.22兆瓦。系统基于国产“灵昆”平台,从芯片、高速互连(灵启网络)、存储到系统软件实现全栈自主可控,是中国超算首次在“从架构定义到整机集成”的全链条上不依赖外部加速器生态登顶世界第一。
支撑这一路线的核心设计是 “在线加速”(Online Acceleration) 的全CPU超智融合架构。其思路是把类似GPU的矩阵加速能力集成进CPU内部,使同一颗芯片既能承担双精度科学计算,又能处理AI训练所需的半精度/整数运算,同时搭载首颗国产HBM(高带宽内存),内存带宽相较传统CPU提升约10倍,从而在CPU体系内消化掉原本需要GPU分担的负载。此外,“灵晟”首创100%全液冷方案,能效比达到52 GFlops/W,在取得全球第一性能的同时兼顾了绿色能效。
🇨🇳 历史坐标:时隔九年后的“稳固领跑”
“灵晟”的蝉联,放在中国超算的历史脉络中具有特殊分量。中国超算上一次位居TOP500榜首,是2017年的“神威·太湖之光”。此后近十年间,榜首长期由美国E级系统占据。“灵晟”在2026年6月首次登顶,是时隔九年中国超算重返世界第一;此次在SC26上蝉联,则标志着这次回归并非昙花一现,而是进入了“稳固领跑”的阶段。
🌍 国际评价与生态意义
TOP500联合创始人、图灵奖得主Jack Dongarra对“灵晟”的评价颇具代表性:“这是一套令人印象极为深刻的系统……让世界看到了超算通向AI4Science新型系统架构的希望之光。”国际同行普遍认为,在以GPU加速器为主导的E级超算格局中,“灵晟”的纯CPU路线证明了通往E级算力的技术路径并非只有一条,为后GPU时代的算力体系结构提供了另一种选择。
在应用层面,“灵晟”已支撑22项千万核级全机规模应用,适配220余款领域软件;基于该系统开展的XLSDFT科研应用成果入围了2026年ACM戈登贝尔奖,显示出国产E级算力正在实际重大科研任务中转化为产出。