天垓(TianGai)是天数智芯(Iluvatar CoreX) 旗下的旗舰通用GPU(GPGPU) 产品线,专为AI模型训练与推理等高性能计算任务设计。它是国内最早实现量产的通用GPU产品之一,经过多代演进,最新旗舰天垓300在特定推理场景下的实测性能已达到甚至局部超越英伟达H200的水平。
📈 产品演进:从“首款量产”到“对标H200”
天垓系列遵循着清晰的迭代路径,从填补国内空白逐步走向与国际主流产品竞争。
| 代际 | 代表型号 | 关键定位与里程碑 |
|---|---|---|
| 第一代 | 天垓100 (Gen 1) | 国内首款量产的通用GPU,2021年发布,采用7nm制程,填补了国产训练GPU的空白。 |
| 第二代 | 天垓150 (Gen 2) | 2023年量产,在算力和架构效率上进行了升级,配备更大的显存,巩固了产品竞争力。 |
| 第三代 | 天垓300 (Gen 3) | 当前的旗舰产品,2026年发布。采用全新“天枢”架构,定位是直接对标并超越英伟达Hopper架构(如H200)的国际主流方案。 |
此外,产品线中还存在天垓200,它被定位为支持“前沿高精度算力需求”的型号,服务于对特定精度有更高要求的科研与训练场景。
🚀 旗舰详解:天垓300的核心规格与突破
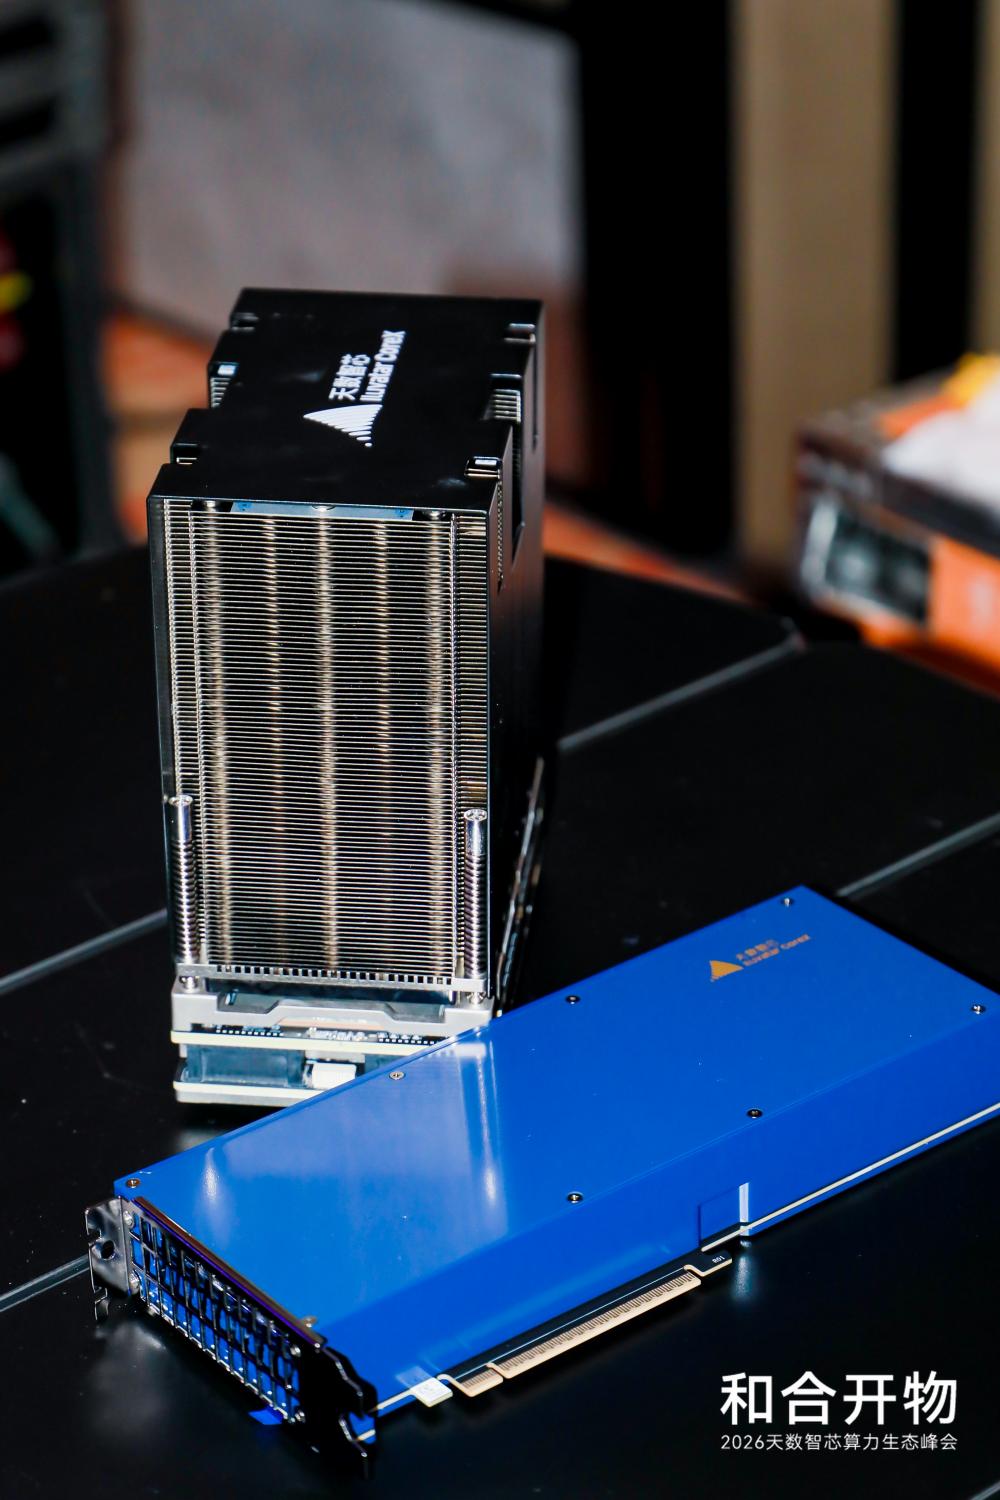
天垓300是理解天垓GPU当前技术高度的关键。
核心硬件规格
- 架构:自研“天枢”SIMT通用计算架构,原生兼容标量、矢量、张量三类计算模式。
- 制程与集成度:采用7nm制程,集成超过1000亿个晶体管和200个以上AI计算核心。
- 算力精度:单芯片FP16算力突破1000 TFLOPS,INT8算力达2000 TOPS以上。全面覆盖FP4、FP8、FP16、BF16等多种数据精度,以适应不同AI负载的需求。
- 显存:配备144GB HBM3高带宽显存,显存带宽突破4TB/s,为处理大模型和海量数据提供了基础。
- 功耗:典型功耗控制在600W以内,并内置智能功耗管理单元。
针对性架构优化 天垓300的架构针对大模型的核心链路进行了专项优化,主要包括Attention计算、MoE(混合专家)模型、AF分离、PD分离以及多卡大规模集群扩展五大模块。
实测性能表现(对比英伟达) 根据第三方实测和官方披露,天垓300在多个关键场景中展现出强劲的竞争力:
- 端到端吞吐:在典型的PD(预填充-解码)分离部署下,单卡端到端吞吐达到NVIDIA H200的1.05倍。
- 长上下文与MoE:在64K长上下文场景下,Attention性能为H200的1.05倍;在GLM-5.3模型上,MoE吞吐达到H200的1.15倍。
- Agent与在线业务:Agent首字延迟较H200降低约10%至30%;在搜广推等在线业务中,推荐推理吞吐提升21%,轻量计算时延降低26%。
- 训练性能:在基于Qwen3-32B模型的8卡整机FP8精度训练中,每卡有效吞吐达到NVIDIA H100的1.33倍。
- 稳定性:满负荷运行的步时波动为0.43%,低于对比Hopper方案的0.76%,显示出更好的长时间高负载稳定性。
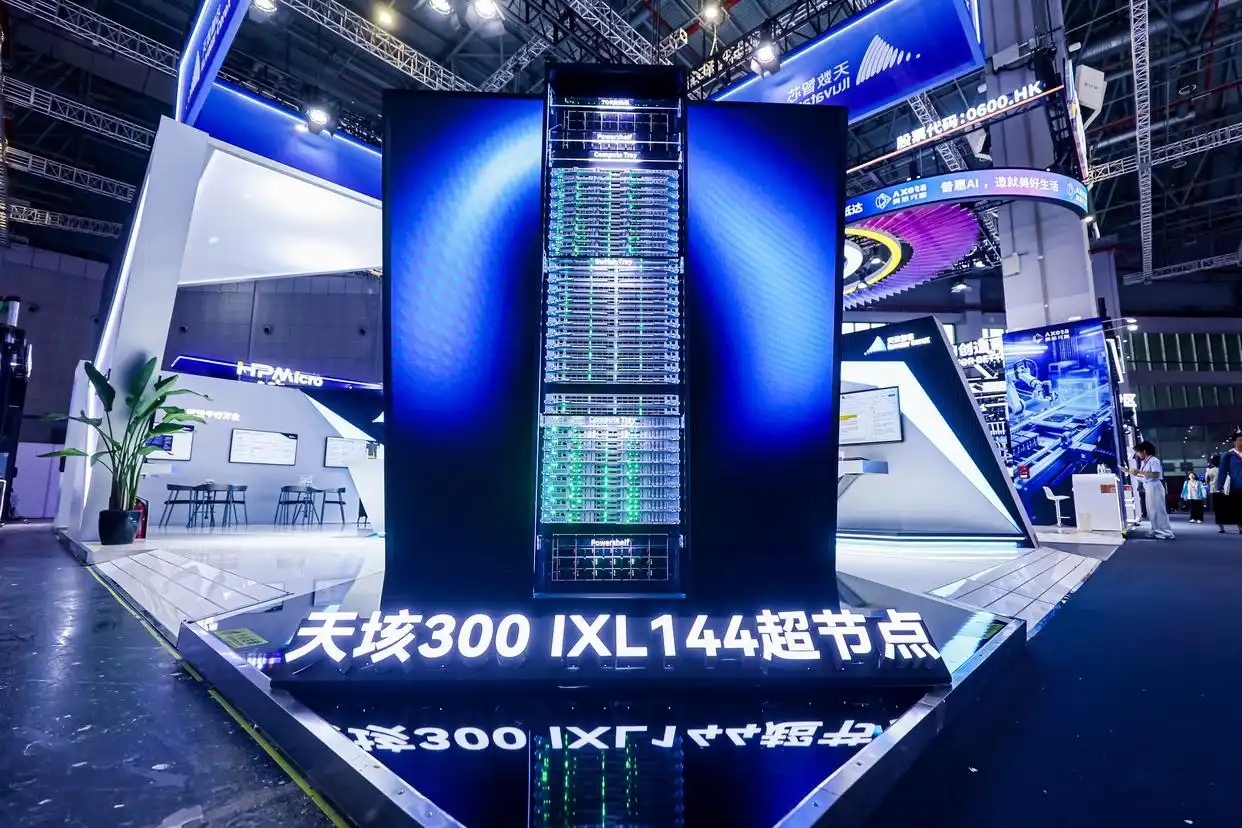
系统级方案:IXL144超节点 天垓300不仅是一颗芯片,更是一套系统方案。其IXL144超节点可在单个标准机柜内集成144颗GPU,聚合约10.1TB显存,是业界密度最高的单机柜GPU超节点之一。据测算,该方案可将每百万有效Token的成本较国际主流方案降低约40%。
💻 软件生态:降低迁移门槛的“天数智算”
对于国产GPU而言,软件生态的成熟度与硬件性能同样重要。天数智芯通过“天数智算”软件栈,采取了高度兼容CUDA生态的策略,以极大降低用户的迁移成本。
- 核心逻辑:绝大多数基于CUDA开发的应用,无需重写代码,仅需使用天数智芯提供的编译器重新编译即可运行。
- 兼容性覆盖:软件栈提供了与CUDA生态位一一对应的工具链,如编译器
ixCC、算子库ixBLAS/ixDNN、通信库ixCCL等。在框架层面,深度适配了PyTorch、TensorFlow、PaddlePaddle以及vLLM、DeepSpeed等主流AI框架。 - 关键差异点:需要注意的是,天垓GPU的Warp Size为64(CUDA为32),涉及底层warp操作的代码在迁移时可能需要针对性调整。
🎯 应用场景
天垓GPU的应用已覆盖从云端到终端的多种场景,其旗舰型号天垓300全面覆盖了生命科学、物理AI、化学与材料四大领域的近百个典型场景,包括蛋白结构预测、药物筛选、机器人仿真、分子动力学等关键任务。同时,它也适配长文本大模型、智能Agent、世界模型等前沿AI任务。
天垓GPU代表了一条清晰的国产通用计算发展路径:从解决“有无”问题的天垓100,到逐步缩小差距并最终在特定场景实现对国际旗舰产品反超的天垓300。其成败不仅取决于单芯片的峰值算力,更在于系统级方案(如超节点)的成本优势与软件生态的易用性,这两点共同构成了其在商业化落地中的核心竞争力。