华为在2026年11月10日至11日对麒麟9050“逻辑折叠”技术的详解,本质上是在先进制程受限的约束下,给出了一套以“空间换制程”的系统级工程答案。它的核心不在于把晶体管做得更小,而在于把信号跑的路缩得更短。
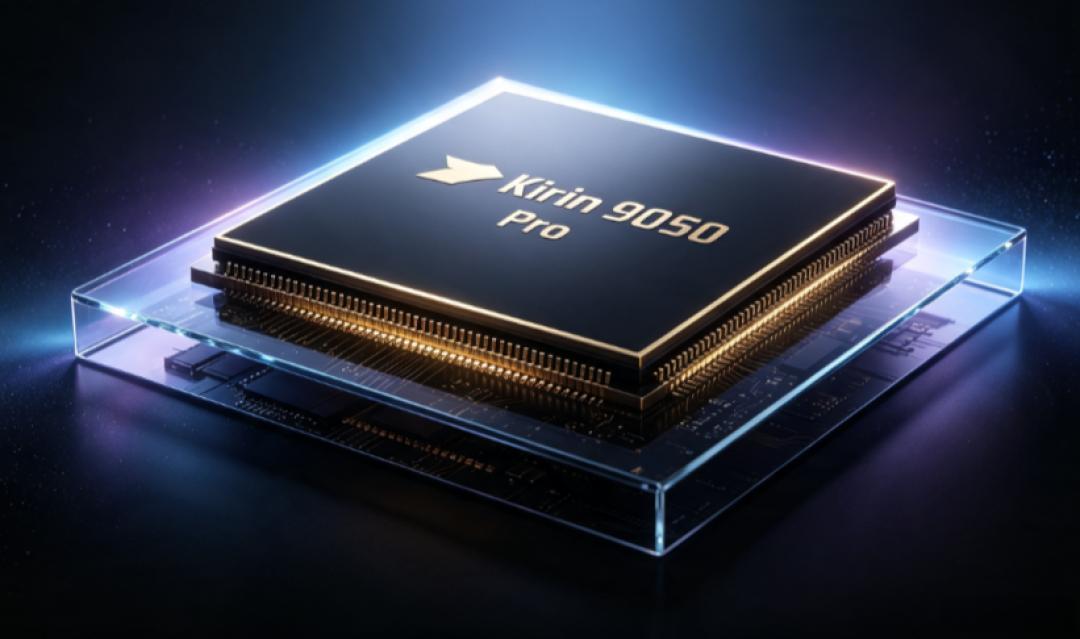
为什么需要“逻辑折叠”:几何缩微撞上了墙
过去几十年芯片性能提升的主线是摩尔定律,靠光刻把晶体管越做越小、在平面上塞进更多单元。但这条路在逼近原子级物理极限后,成本指数级上升,收益却越来越薄。
华为提出的替代思路是“韬定律”(τ scaling) :不再执着于几何缩微(把晶体管做小),转而追求时间缩微——压缩信号在芯片内部的传播时延,让数据少绕路、少等待,在相近的芯片面积内集成更多有效运算单元。逻辑折叠就是韬定律落地的第一个核心工程手段。
逻辑折叠的物理实现:把“平房”改成“复式楼”
传统芯片的电路是平面平铺的,所有逻辑单元在同一层,信号需要在平面上长距离绕行,延迟和功耗都消耗在“路上”。
逻辑折叠做的事情,是把原本平铺的逻辑电路折成上下两层,两层之间用混合键合(Hybrid Bonding) 直接贴合,再通过垂直互连通道传输信号。官方披露的关键工程数据是:
- 混合键合超过5000万处;
- 有效信号互连超过500万条;
- 晶体管密度提升53.5%,麒麟9050 Pro达到2.38亿/mm²。
更具体地说,麒麟9050 Pro并不是一颗单层大芯片,而是两颗尺寸完全相同的裸片(Die)垂直堆叠:一颗负责核心计算逻辑(Logic Die),另一颗专用于SRAM和缓存(SRAM Die),两者通过高密度垂直互连连接,跨Die传输带宽高达125TB/s。每颗裸片尺寸为11.13 × 10.84 mm,面积约120.65mm²,甚至略小于前代麒麟9030S的122mm²——在面积没有膨胀的前提下,通过垂直堆叠获得了显著更高的等效晶体管密度。
何庭波在论文中给出的一个关键判断是:这一代通过逻辑折叠获得的密度增幅,相当于此前三年依靠几何尺寸缩小所取得的成果总和。
端侧30B大模型:NPU的能效账才算得过来
逻辑折叠本身解决的是“算力密度”问题,但它对端侧AI的意义,是通过新一代达芬奇架构NPU转化为可感知的能力跃升。
麒麟9050 Pro的NPU算力提升140%,能效提升66%,官方明确支持30B参数的MoE(混合专家)大模型在手机端侧运行,不依赖联网,也不等待云端。
30B模型上手机,最大的障碍从来不是“能不能跑”,而是功耗和内存。MoE架构在这里是关键:30B总参数中每次推理只激活约20亿参数,新增内存占用低于2.5GB。配合NPU的多级存算协同优化和低比特量化,端侧推理的功耗才能被压到手机可以持续承受的范围内。华为同时部署了7B Dense文本模型(首字响应提升180%,推理功耗降低29%)和6B图像编辑模型,与30B MoE形成分工:30B负责需要深度推理的多步任务规划,6B和7B分别承担修图和快速文本响应。
落到具体功能上,这套NPU组合支撑的是离线状态下的复杂任务规划、智能修图、多模态感知,以及持续在线的AI屏幕朗读、眼动翻页、熄屏地图等感知型体验。它的意义在于把一部分原本必须上云的AI任务拉回本地,延迟从“网络往返”压缩到“芯片内垂直互连的距离”。
围绕逻辑折叠的配套升级
逻辑折叠不是孤立的技术,麒麟9050 Pro的其余单元也围绕“缩短路径、提升每瓦性能”做了同步调整:
- 灵犀CPU:9核16线程异构设计(1×3.1GHz超大核 + 2×2.7GHz性能大核 + 4×2.2GHz能效大核 + 2×1.75GHz小核),最高频率提升12.7%,大核能效提升41%。
- 马良GPU:6核微架构,渲染性能提升40%,功耗降低45%。
- 巴龙AI Modem与独立安全处理器,以及FFTS函数流任务调度器(每秒50万次高并发调度、微秒级时延),共同构成通信、安全与多任务并行的底层支撑。